
2017年6月12日(最初のプレプリント公開) / 南北アメリカ
Transformerがアテンションを軸に系列モデルを構成する
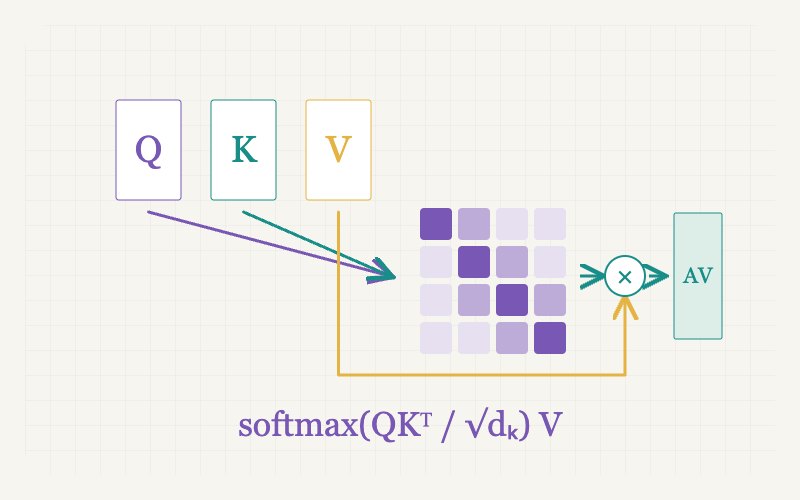
Attention Is All You Needは、系列の要素間をアテンションで関連づけるTransformerを導入し、機械翻訳でその構造を検証した。
画像を表示できません。説明と出典は引き続き読めます。
記事
ヴァスワニと7人の共著者の論文は、系列モデル化の基幹に再帰や畳み込みを使わず、エンコーダー・デコーダー構造にアテンション、位置エンコーディング、フィードフォワード層を組み合わせた。実験の中心は機械翻訳であり、今日のチャットアプリケーションや汎用知能の証明ではない。アテンションには先行する歴史があり、その後の事前学習、データセット、構造変更はさらに後の発展である。したがって、一つの論文が人工知能すべての起源を表すわけではない。
つながりと背景
この構造は、ニューラルネットワークの学習とアテンションの研究を土台としていた。データ、計算ハードウェア、最適化、評価も後の用途を形づくった。ネットワーク図だけでは、その発展を説明できない。
年代と精度
2017年6月12日(最初のプレプリント公開) 記録された日付
記録された年・月・日に基づいて位置づけています。不明な精度を推定で補ってはいません。
地図の代表地点
マウンテンビューとGoogleの共同研究
マウンテンビューはGoogleの研究環境を表しており、論文に示された正確な実験住所ではない。所属にはGoogle BrainとGoogle Researchが含まれる。
代表地点の座標 · 37.422°, -122.084°
地点は、写本の所蔵先、実験室、観測地など、一つの代表的な場所を示します。研究がそこでしか行われなかったことを意味せず、共同の発見を一つの国に帰属させるものでもありません。
参考文献
- ヴァスワニと共著者 | Attention Is All You Need(アテンションだけで十分)、最初のプレプリント
- Google Research | Attention Is All You Need(アテンションだけで十分)
参考資料は、外部リンクなしの書誌タイトルとして表示します。個々の事実や背景を支えるもので、記事のすべての解釈を保証するものではありません。日本語版は英語版の本文を翻訳し、英語版が独立に選定した参考資料の原URLを保持しています。日本語の原資料であることや、日本語を母語とする編集者による独立した校閲が済んでいることを示すものではありません。