
2017年6月12日(论文首版公开) / 美洲
Transformer用注意力机制组织序列模型
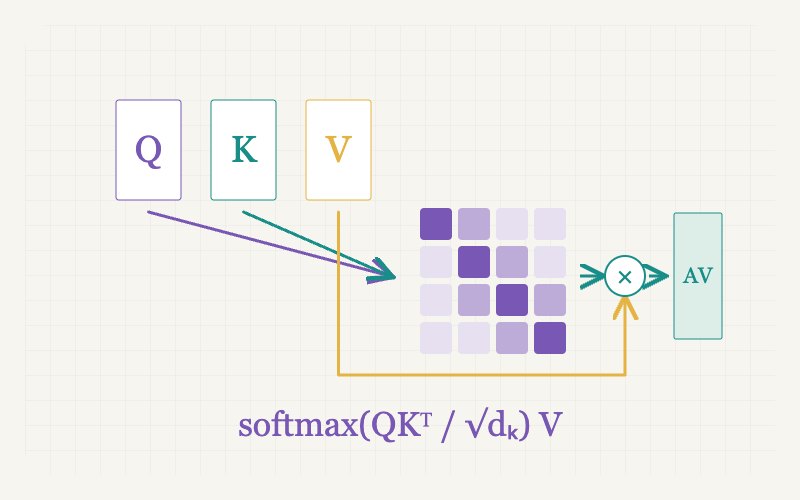
《Attention Is All You Need》提出Transformer架构,以注意力机制组织序列间的关系,并在机器翻译任务中检验性能。
图片暂时无法显示,仍可阅读图注与来源。
科学史故事
Vaswani等八位作者公开的论文,用注意力、位置编码和前馈层构成编码器与解码器,避免把循环或卷积作为序列建模的基本结构。实验主要考察机器翻译,不等于已经造出今日的聊天应用或证明通用智能。注意力机制此前已有研究,后来的预训练、大规模数据与模型改造也是新的阶段,不能把人工智能的发展归结为一篇论文。
联系与背景
这一架构承接神经网络训练与注意力研究。理解它还需要看到数据、算力、优化和评测的共同作用,而不只是一张网络结构图。
年代与日期精度
2017年6月12日(论文首版公开) 明确节点
按资料明确记载的年、月或日定位;未详的月日不作推定。
地图代表点
山景城及Google研究协作网络
以山景城代表Google研究环境,不是论文给出的精确实验地址;作者来自Google Brain、Google Research及相关合作背景。
代表点坐标 · 37.422°, -122.084°
代表点可指一份手稿的收藏地、实验室或观测地点,不表示研究只在此发生,也不把共同发现单独归于某一国家。
资料依据
- 上海交通大学Hello AI课程:每个词都能看见其他词(原始Transformer)
- 中国科学院自动化研究所:发展AI,融合人脑智慧(2017年架构背景)
资料以书目标题展示,不提供外部跳转。参考资料可能支持个别事实或相关背景,列出来源并不等于每一句解释已经逐句核实。